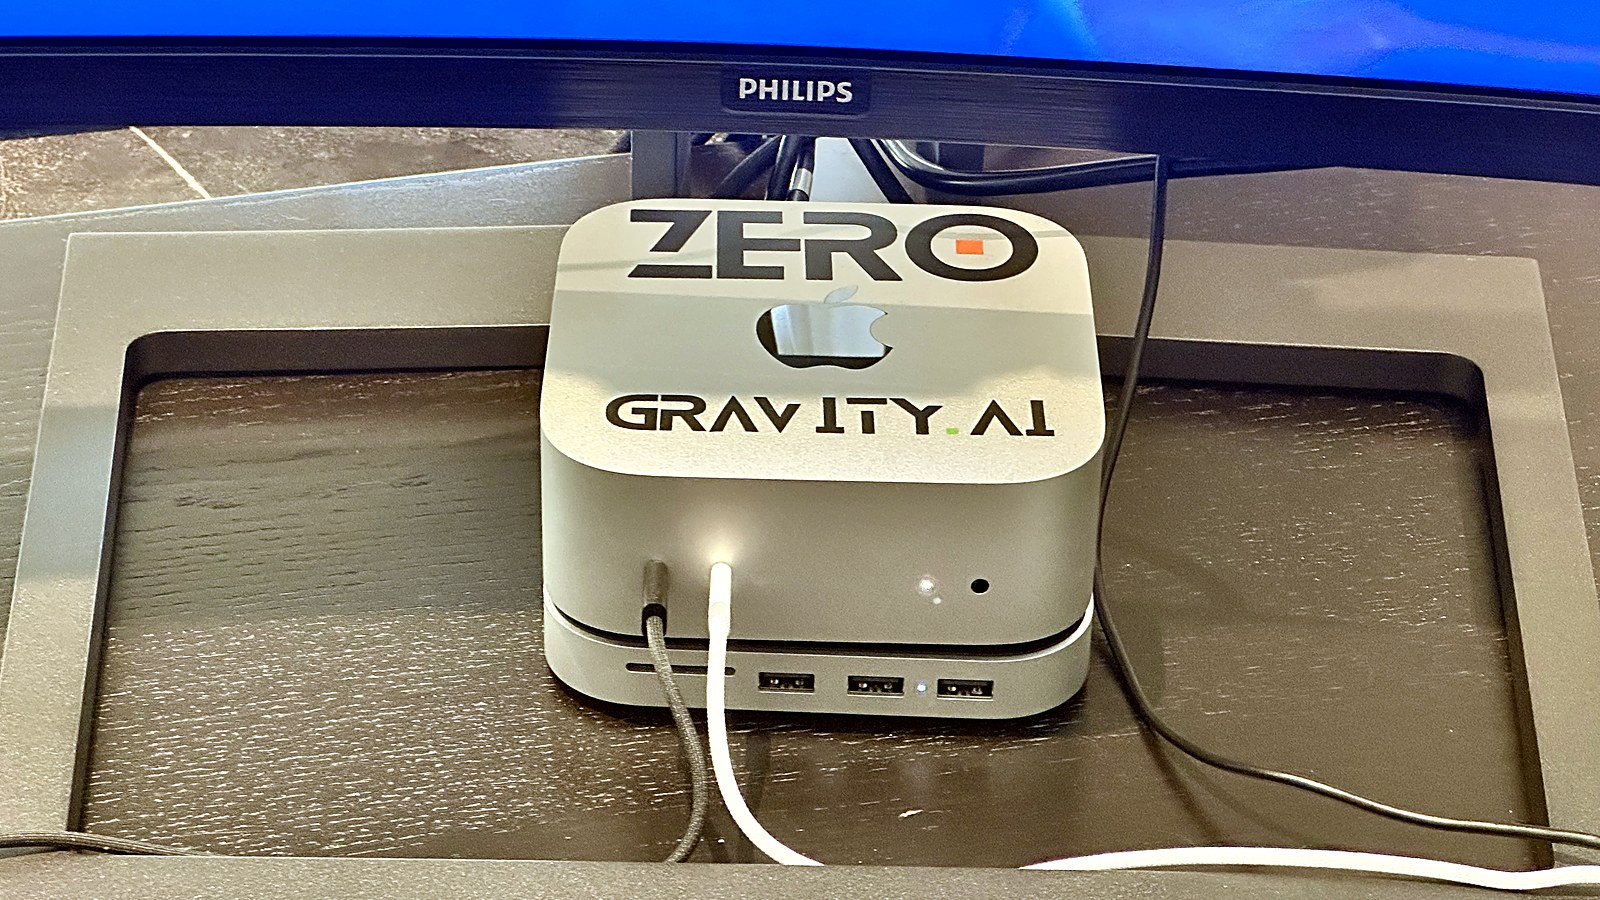
| Hardware | Mac Mini M4 Pro, 64 GB gedeeld geheugen |
|---|---|
| Modelserver | Ollama, als achtergronddienst |
| Taalmodel | qwen3:32b |
| Zoeken in documenten | nomic-embed-text |
| Bereikbaarheid | Private tunnel naar Cloudflare, met toegangscontrole |
| Als de Mini uit staat | Cloudmodel via Cloudflare Workers AI, zichtbaar gemarkeerd bij het antwoord |
| Gebruikers | 3 community-agents en 6 interne agents |
| Locatie | Noord-Brabant, Nederland |
Waarom een Mac Mini?
Bij een Mac met Apple Silicon delen processor en grafische chip hetzelfde geheugen. Met 64 GB past een model van 32 miljard parameters ruim, met plek voor embeddings en lange gesprekken ernaast. Op een pc heb je voor hetzelfde model een GPU met minstens 24 GB videogeheugen nodig.
Hij is stil en klein genoeg om op een bureau te staan. Dat maakt het makkelijk om hem dag en nacht aan te laten.
Hoe een vraag bij de Mini komt
Een lid typt een vraag in het portal. Die gaat over https naar onze diensten bij Cloudflare, waar ook de website, de ledenlijst en de gespreksgeschiedenis staan. Cloudflare stuurt de vraag door een private tunnel naar de Mini. De Mini rekent het antwoord uit en stuurt het terug.
De Mini heeft dus geen open poort naar internet. Alleen de tunnel komt binnen, en die vraagt om toegangsgegevens.
Wat we onderweg leerden
Geplande taken en de Keychain
Wij bewaren tokens in de macOS Keychain. Een cronjob kan die niet lezen, omdat cron buiten de inlogsessie draait. Geplande taken die geheimen nodig hebben, zetten we daarom als LaunchAgent op.
Processen na een herstart
Na een update of stroomstoring moet alles vanzelf terugkomen. Onze workflowtool draait daarom onder een procesmanager die hem na een herstart opnieuw start.
localhost of 127.0.0.1
Sommige tools zoeken bij localhost eerst een IPv6-adres, terwijl Ollama op IPv4 luistert. Verbindingen mislukten dan zonder duidelijke fout. Met 127.0.0.1 als adres was dat opgelost.
Eén machine is één wachtrij
Komen er tegelijk veel vragen binnen, dan wachten ze op elkaar. Voor een community en een handvol agents is dat prima. Voor honderden gelijktijdige gebruikers is een Mac Mini te klein.
Wanneer past dit bij jou?
Een Mac Mini als AI server past als een klein team of een groep agents één model deelt en je wilt weten waar het rekent. Wil je veel gebruikers tegelijk bedienen, of modellen trainen, dan heb je andere hardware nodig.
Wil je dit zelf bouwen, dan loopt Han in het Builder-spoor met je door de keuzes. Meer over de basis staat op AI lokaal draaien.
Veelgestelde vragen
Hoeveel geheugen heeft een Mac Mini nodig als AI server?
Met 16 GB draai je modellen van 7 à 8 miljard parameters. Met 32 GB past een model van 32 miljard krap. Wij kozen 64 GB, zodat het 32B-model, de embeddings en lange gesprekken naast elkaar passen.
Kan een Mac Mini meerdere gebruikers aan?
Een paar tegelijk. Vragen worden na elkaar verwerkt, dus bij drukte loopt de wachttijd op. Voor veel gelijktijdige gebruikers is een server met meer rekenkracht beter.
Wat gebeurt er als de Mac Mini uitvalt?
Bij ons neemt een cloudmodel het tijdelijk over. Onder elk antwoord staat of het op de Subfactory of door de cloudfallback is gemaakt.
Is macOS geschikt als server?
Voor één machine met vaste taken werkt het goed, mits je automatische herstart, LaunchAgents en een procesmanager inregelt. macOS is geen serverbesturingssysteem, dus voor grotere opstellingen ligt Linux meer voor de hand.
Doe mee met het Builder-spoor
Lid worden is gratis. Je kiest een spoor, krijgt een eigen AI-agent en leert van wat andere leden in de praktijk tegenkomen.
Word gratis lid